Eu queria consultar leis federais no celular do mesmo jeito que consulto na web: abrir o texto, buscar com palavras comuns, ler. Não um banco jurídico com conta e sincronização, nem um chat que resume a lei: o texto literal, offline, e um campo de busca que entende a pergunta.
O Planalto publica o texto integral de toda lei federal brasileira em HTML, de graça, sem API. Então o app monta a própria biblioteca a partir dessas páginas, no aparelho: baixa, faz o parse, guarda e indexa. O resultado é o Lista Leis, um app Android com 121 leis em 17 áreas, no Google Play. Sem backend, sem conta, sem analytics; as únicas chamadas de rede vão para as páginas do Planalto e para o Google Play, na cobrança.
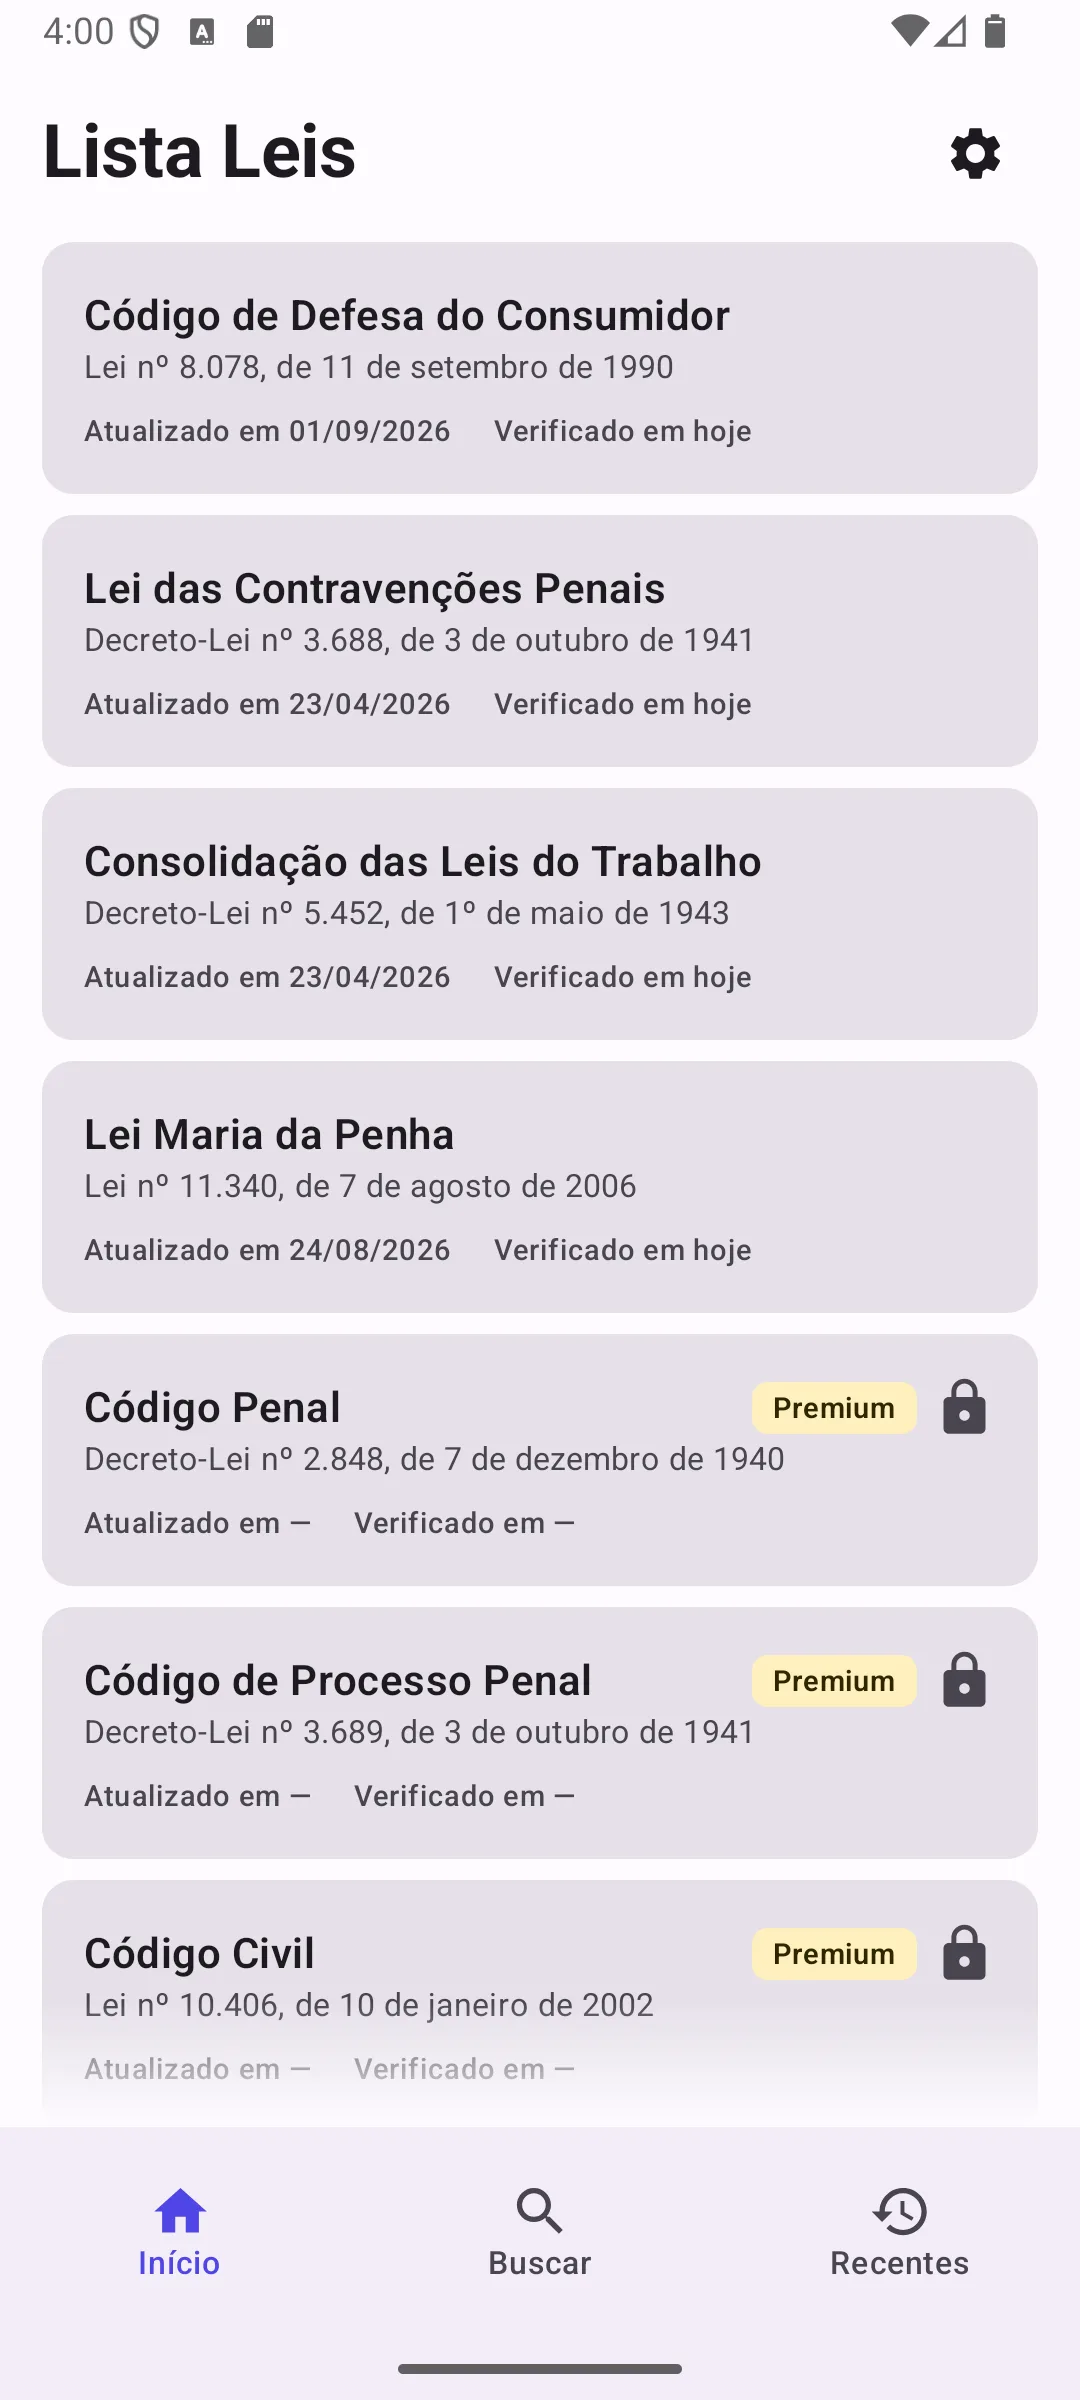 A tela inicial: as quatro leis gratuitas prontas para ler, o resto marcado como Premium.
A fonte é uma página feita para leitura, não para parsing
O catálogo inteiro vem de um único tipo de fonte: uma página HTML por lei, no planalto.gov.br. Não existe feed, nem JSON, nem changelog. Existe uma página escrita para humanos, e o app lê exatamente isso. Três características dessas páginas moldam todo o trabalho de parsing.
A marcação é antiga e irregular. A maioria das páginas é ISO-8859-1; uma delas (Maria da Penha) é servida como UTF-16LE com o último byte cortado no servidor, então o decodificador tem que olhar o BOM antes de assumir uma codificação. A fonte também tem erros de digitação próprios, como um cabeçalho de capítulo corrompido na Lei das Contravenções Penais.
O mesmo artigo pode aparecer duas vezes. Quando uma alteração reescreve um artigo, a página mantém o texto antigo e anexa o novo, marcado “Redação dada pela Lei X”. A ordem de leitura engana, então o parser fica com a última ocorrência de cada número de artigo.
Citações parecem a própria lei. Quando uma lei cita artigos de outra norma, a citação fica dentro de um <blockquote> e contém cabeçalhos como “Art. 1º”. Sozinha, cada citação viraria um artigo fantasma da lei que está sendo lida. O parser remove os blockquotes recursivamente, dos mais internos para fora:
// Citações de outras leis parecem artigos: fora.
// Remove os blocos mais internos primeiro, até a página parar de mudar.
val inner = Regex("""(?is)<blockquote\b[^>]*>(?:(?!</?blockquote\b).)*</blockquote>""")
while (true) {
    val next = inner.replace(out, "")
    if (next == out) return out
    out = next
}
A partir daí, o parser percorre elementos p, h1, h2 e h3, quebra cada um em linhas nos <br> e reconhece três coisas: cabeçalhos de artigo, divisões (PARTE, LIVRO, TÍTULO, CAPÍTULO, SEÇÃO) e epígrafes, a rubrica curta em negrito que nomeia o artigo. O número precisa sobreviver ao que a fonte faz com ele: Art. 42, Art. 1.595 com ponto de milhar, Art. 9º-A de uma alteração, e Art. 1o com o ordinal em <sup>. A base mantém um padrão conservador, e cada lei pode optar por uma exceção quando a própria página faz diferente: o Código Eleitoral escreve Ar. e At., a Lei das Eleições escreve Art sem ponto, e o Código de Processo Penal Militar (CPPM) tem uma linha em negrito (“Parte de deserção”) que parece uma divisão mas é uma nota dentro do artigo. Nenhuma exceção muda como qualquer outra lei é lida.
Existe ainda um marcador de fim de documento: o aviso “Este texto não substitui o publicado no DOU”. Só que nem sempre no fim. A Lei 8.112 tem dois deles, um dentro de uma nota de republicação; só a última ocorrência encerra o documento.
Por isso o app carrega um parser por lei quando precisa. É o mesmo problema repetido em 121 páginas que discordam entre si.
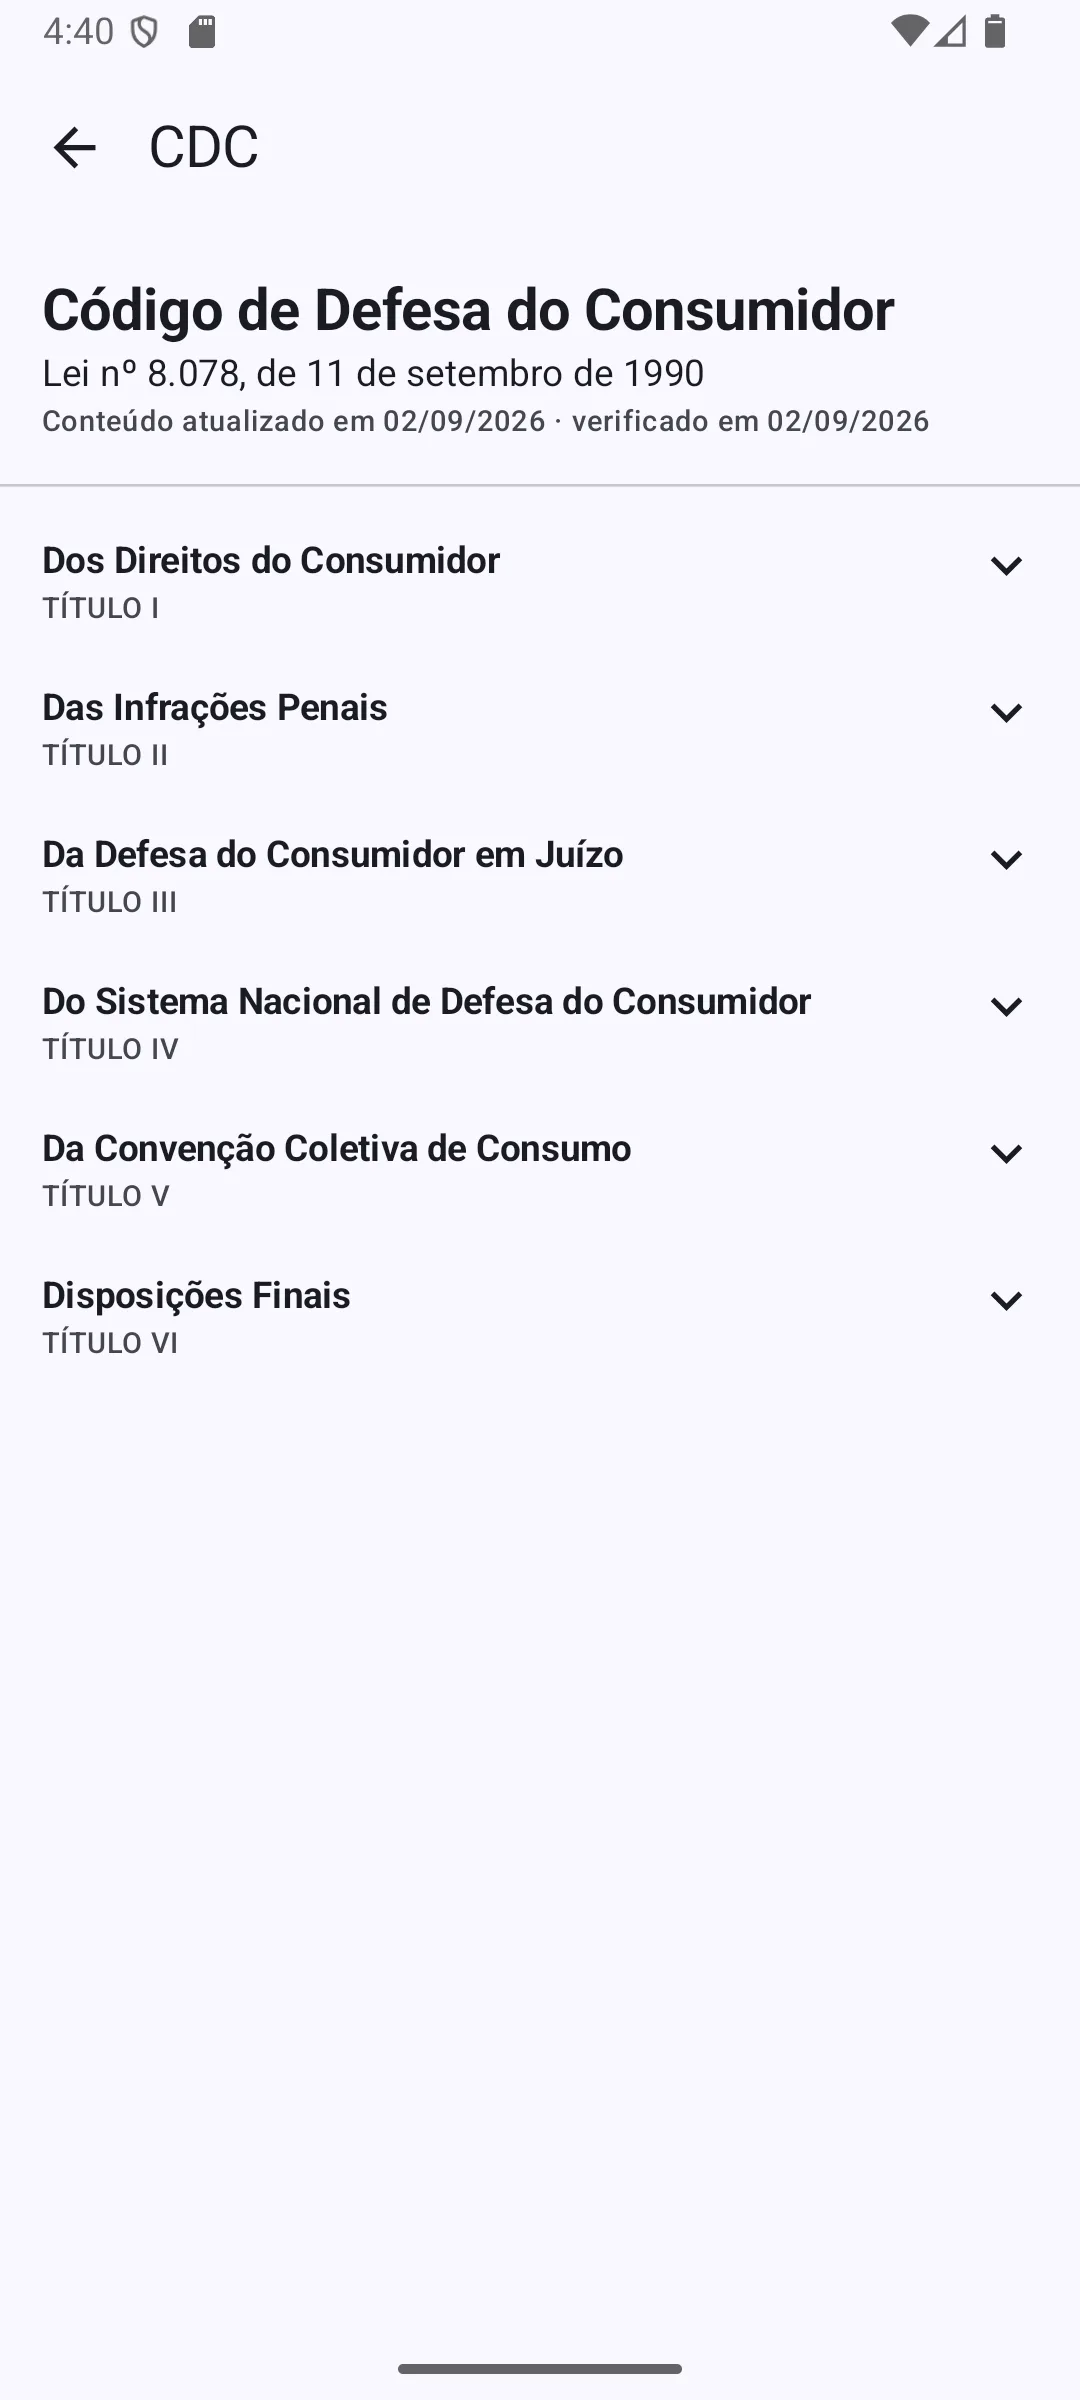 O índice da lei: as divisões aparecem como títulos e capítulos, na mesma estrutura da fonte.
O hash decide se algo mudou
Uma biblioteca de 121 páginas só vale a pena conferir se a conferência é barata. Cada download calcula um SHA-256 da página depois de remover os <script>. O Planalto injeta um script anti-bot com payload que muda a cada carregamento; calcular o hash do HTML cru marcaria toda lei como alterada todas as vezes.
O hash guardado também carrega a versão do parser: sha256(stableHtml(html)) + ":p" + parseVersion. Quando a lógica de parsing melhora, o hash da versão anterior deixa de casar e a próxima passada reconstrói a lei, sem migração de banco.
Hash igual significa conteúdo igual, e o app só atualiza a data de “verificado em”. Hash diferente significa refazer o parse: seções e artigos são substituídos dentro de uma transação única, o hash é gravado por último (um crash no meio nunca deixa uma lei marcada como ingerida com zero artigos) e o cache de busca é invalidado. Um parse vazio é tratado como página de erro transitória da fonte, não como uma lei sem artigos: o conteúdo anterior fica e o app tenta de novo depois.
A busca com as palavras que você tem
Um campo de busca que exige a palavra-chave certa não serve para uma biblioteca de leis. Se alguém digita “cobraram duas vezes o mesmo item”, o artigo que responde provavelmente diz “cobrança indevida”. Então cada artigo recebe um embedding no aparelho com um Universal Sentence Encoder, via MediaPipe. O modelo tem cerca de 6 MB e vem dentro do APK, sem download na primeira execução; os vetores ficam como blobs no mesmo banco local do texto, e a consulta também vira um embedding na hora da busca, comparada ao corpus por similaridade de cosseno.
O ramo semântico sozinho seria uma caixa-preta, então o ranking junta quatro sinais:
| sinal | o que é | peso |
|---|---|---|
| semântica | cosseno entre a consulta e cada embedding de artigo | o score base |
| palavra-chave | LIKE sobre o texto do artigo | 0,7, com bônus quando acerta a epígrafe |
| aproximada | similaridade de Levenshtein entre termos da consulta e tokens do artigo | entra a partir de 0,62, soma 0,3 |
| número do artigo | “art. 42” reconhecido na consulta | 2,0, lidera a lista |
O caminho do número existe porque as pessoas buscam artigo por número, e um artigo exato nunca deve perder para um parecido por significado. O caminho aproximado é a tolerância a erro de digitação: é o que faz “sussego” encontrar “sossego”.
O resultado sai em duas passadas. O ranking de palavra-chave é emitido primeiro, em dezenas de milissegundos, e o ranking final mesclado o substitui quando o embedding e a passada aproximada terminam. Falha no embedding não quebra a busca: aquele ramo contribui vazio e o resultado sai dos demais. Consultas repetidas caem num cache local com validade de sete dias, guardado por escopo, então uma busca dentro de uma lei é cacheada separada da busca global.
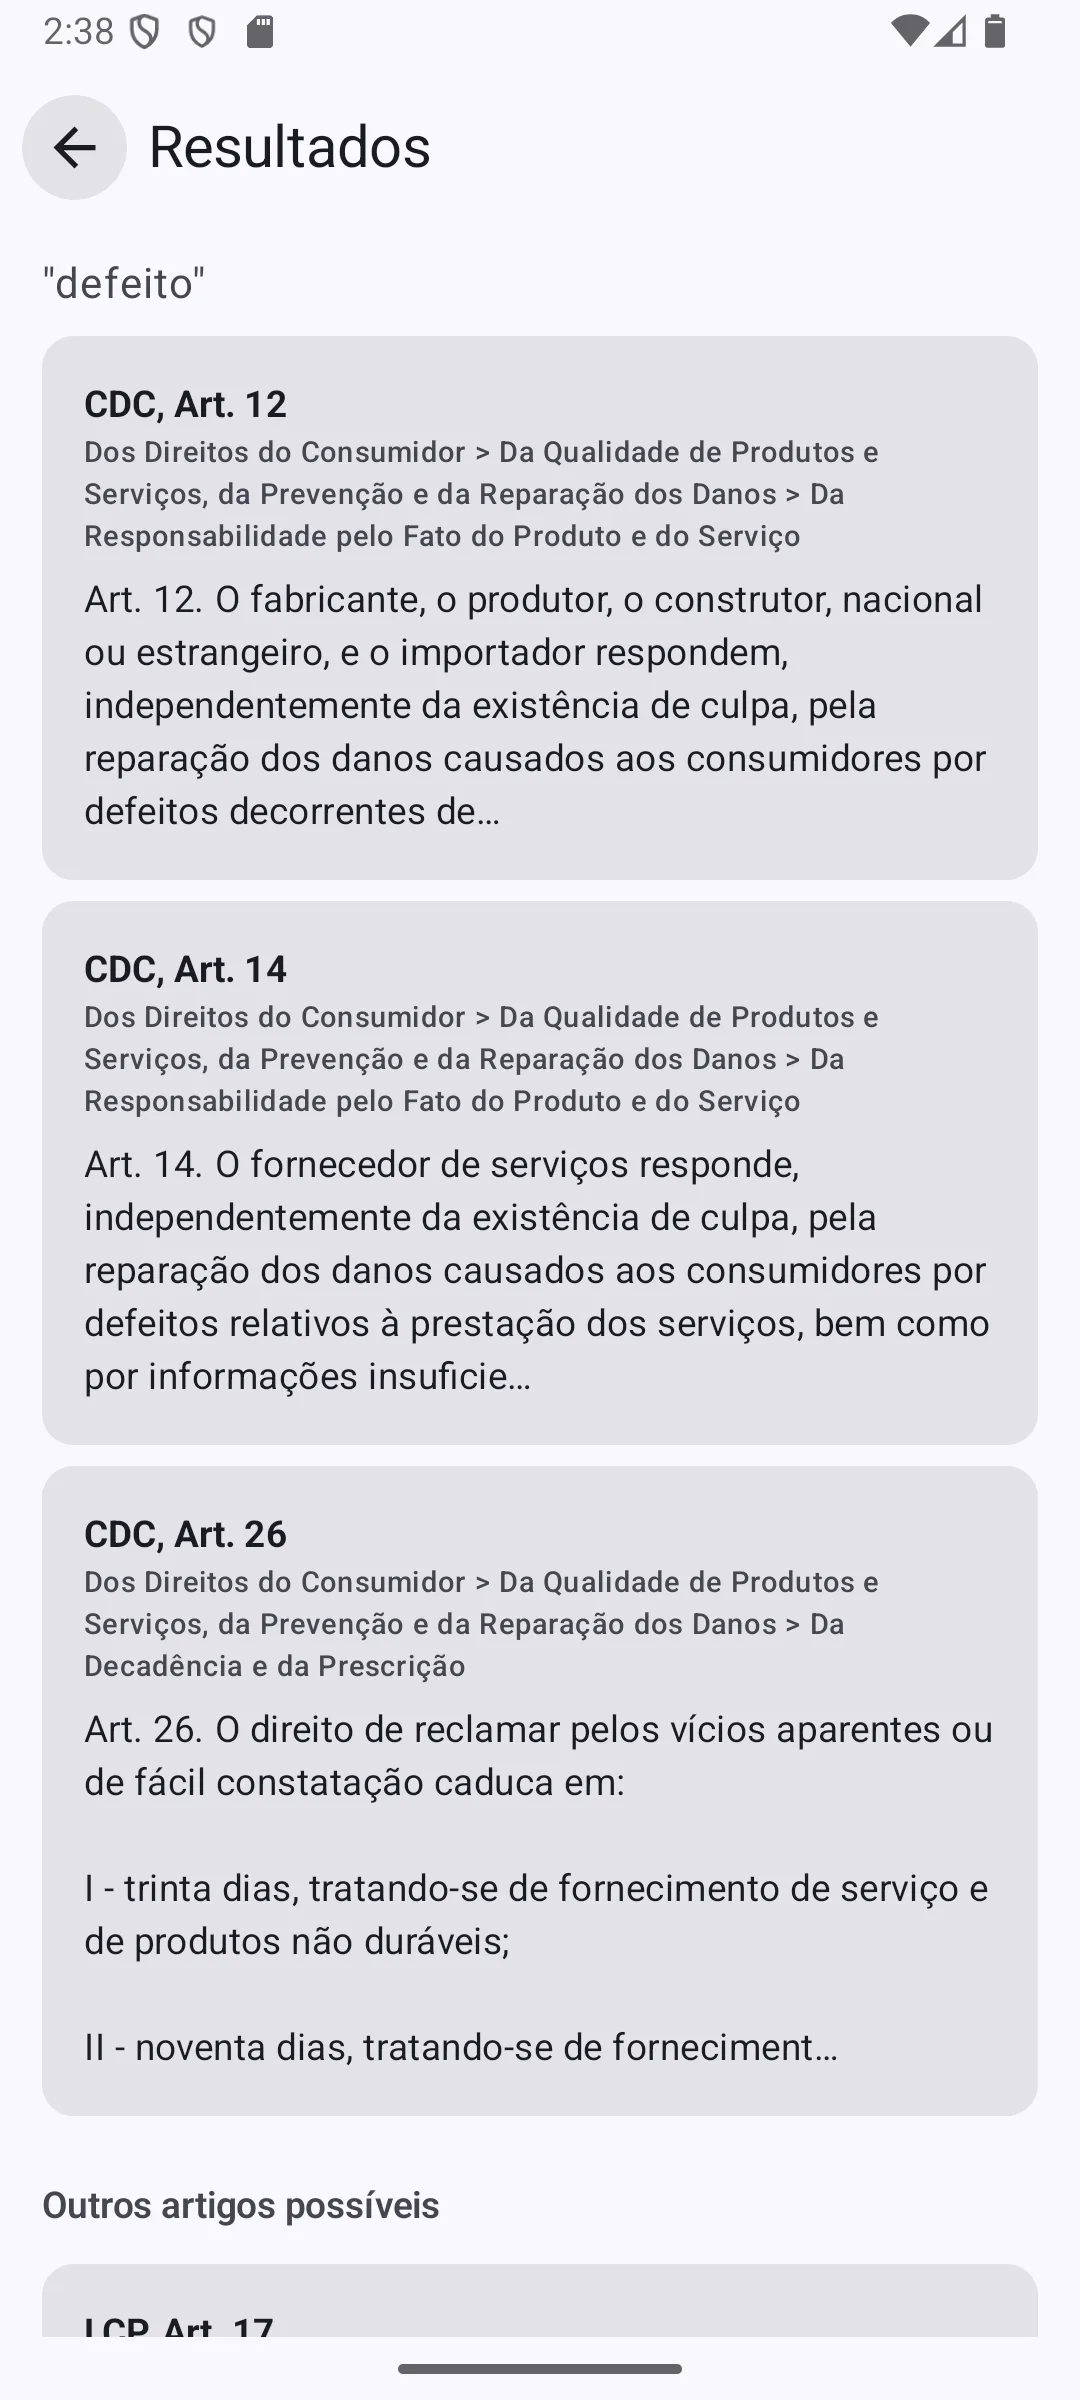 Busca por “defeito” no Código de Defesa do Consumidor: o caminho das seções aparece acima de cada artigo, e o grupo principal fica separado de “Outros artigos possíveis”.
Ler primeiro, indexar depois
Fazer o parse de uma lei é rápido. Gerar os embeddings dela não é. O app mantém duas filas seriais: baixar e parsear, e indexar. A lei fica legível assim que é parseada, ainda sem vetores; os embeddings chegam em segundo plano. Abrir uma lei a move para a frente das duas filas, e a indexação é interrompida entre artigos, gravando cada vetor conforme calcula, então ela retoma do primeiro artigo que ainda está sem vetor.
Numa instalação nova, as quatro leis gratuitas baixam de imediato; as pagas entram na mesma fila depois que a compra é restaurada.
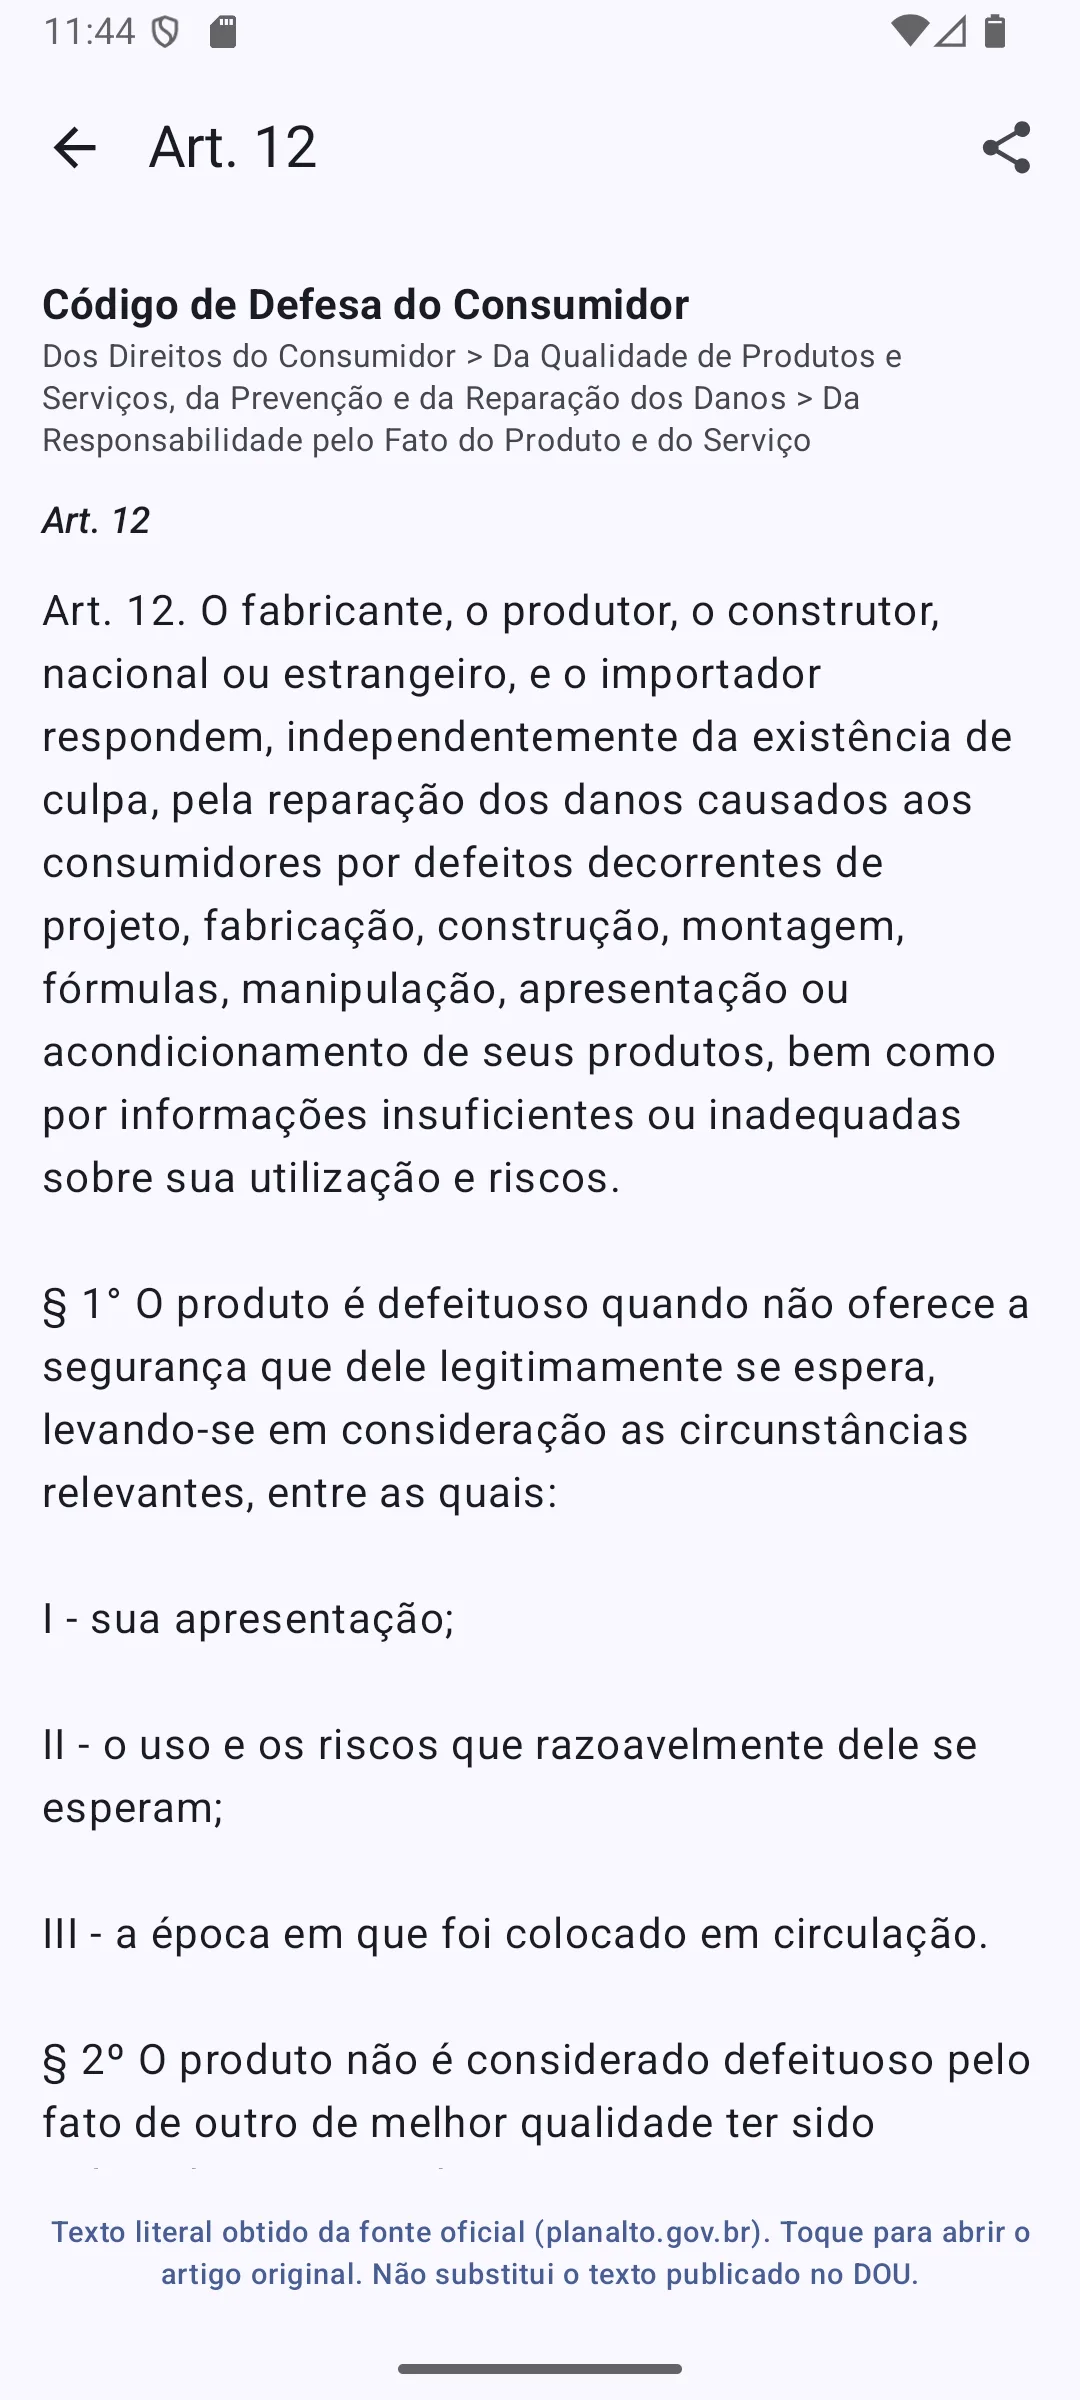 O leitor, com o texto literal e o link para a fonte. A nota de rodapé repete o que o texto é: literal, da fonte oficial, e não substitui o Diário Oficial.
Texto público, ferramenta paga
O texto da lei federal brasileira é público: pode ser copiado livremente, e o app o pega da fonte oficial e mostra literalmente. O que o app vende é a ferramenta em volta: a busca no aparelho, a biblioteca offline, o catálogo além das quatro primeiras leis. Essas quatro são gratuitas para todo mundo: Código de Defesa do Consumidor (CDC), Lei das Contravenções Penais (LCP), CLT e Lei Maria da Penha. As outras 117 são liberadas com assinatura mensal ou anual, ou com uma compra vitalícia de fundador. A cobrança passa pelo Google Play, então a compra acompanha a conta Google e se restaura num aparelho novo sem conta dentro do app.
Limites honestos
Três coisas que o app não é:
- É um leitor, não um parecer. Ele mostra o texto literal com link para a fonte e não resume nem interpreta nada; a publicação no Diário Oficial é o que vale.
- A fonte pode mudar por baixo dele. Os parsers são testados contra trechos das páginas reais, e uma página que para de parsear mantém o conteúdo anterior no lugar, mas um redesenho no Planalto quebra o parser, e isso não é algo que o celular conserte sozinho.
- A busca semântica ordena, não responde. Ela pode deixar passar um artigo relevante ou ordenar diferente do que uma pessoa ordenaria; a busca exata por número e o piso de palavra-chave são as garantias, o resto é ranking.
O app é um repositório independente de textos legais, sem vínculo com qualquer órgão do governo.
Se você quiser conferir qualquer coisa que o app mostra, o caminho é o mesmo do código acima: planalto.gov.br mais a página da lei. Qualquer navegador e um view-source resolvem o resto. O mesmo texto está no app, byte a byte, porque é o único tipo de fidelidade que vale prometer.